Теговый контур: параллельная архитектура захвата спроса на жёстком каталоге
Как рядом с ригидным каталогом маркетплейса построить параллельный контур из более чем ста тысяч статичных теговых страниц, размножить его на сеть языковых доменов и вывести на долю около 8% всей органики.
- КлиентЕвропейский маркетплейс коммерческой и строительной техники, сеть языковых доменов
- РольАрхитектура, таксономия, правила подготовки, процесс загрузки, перелинковка, контроль качества, мониторинг, разбор результата
- РезультатСотни тысяч сессий за год, около 8% органики четырёх доменов
Задача
Клиент: европейский маркетплейс коммерческой и строительной техники, сеть языковых доменов.
Проблема. Маркетплейс большой, но сам он страницы добавлять не может. Новая категория, марка или подкатегория заводится в каталог полгода или год, и только при одновременном выполнении нескольких граничных критериев — например, наличия активного стока в определённом объёме. Плюс сам каталог ригиден по структуре: страница в принципе может существовать только по вертикали «марка / модель» или «категория / подкатегория». Никакой другой срез спроса в него не помещается.
Практическое следствие: SEO-продвижение за счёт новых страниц каталога было почти невозможно. Новая семантика захватывалась стихийно — за счёт бесконечного количества кастомных объявлений, которые потом уходят в архив и лежат там годами. Процесс неуправляемый, а издержки у него постоянные: index bloat и каннибализация.
Гипотеза. Если каталог нельзя расширить, нужен параллельный контур страниц, который живёт по своим правилам, не трогает каталог и при этом закрывает те срезы спроса, которые каталог структурно не умеет выражать.
Роль. Проект вёл end-to-end, кроме сбора семантики: архитектура, таксономия, правила подготовки, процесс загрузки, перелинковка, контроль качества, мониторинг, разбор результата.
Итерация 1: фасеты с костылями. Не взлетела
Первый подход строился на существующих внутренних фасетах. Схема была такая: создаём страницу, контент которой опирается на фасет, затем добавляем этот URL в исключения robots.txt, снимаем meta noindex, прописываем canonical и мета-теги.
Что получилось. Спрос захватывался — страницы приводили трафик. Но:
- Google постоянно выкидывал страницы из индекса. Стабильности не было: сегодня страница в индексе, через месяц нет, без внятной причины.
- Плодились костыли. robots.txt разрастался до 1000+ записей исключений — файл становился нечитаемым и неподдерживаемым, а любая ошибка в нём стоила дорого.
Вывод, который лёг в основу второй итерации: проблема была не в контенте и не в семантике, а в том, что страница жила на параметрическом URL. Пока адрес выглядит как фасет, поисковик относится к нему как к фасету — независимо от директив, которыми его обвешали.
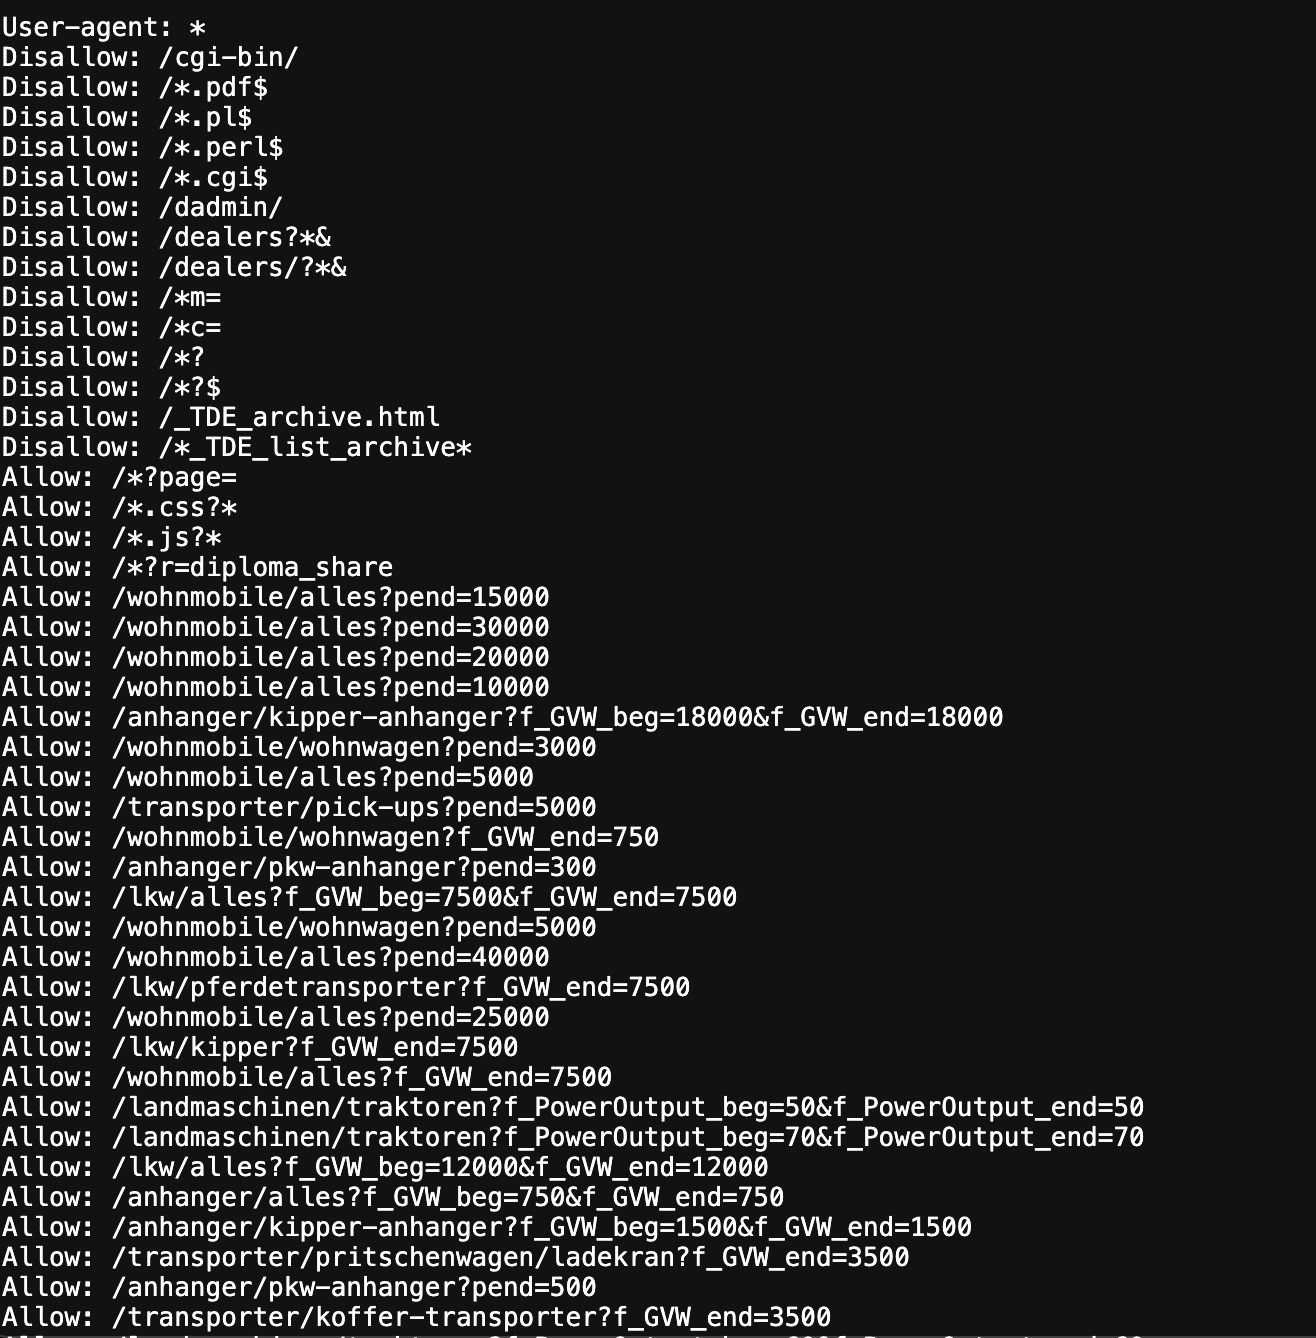
Костыли первой итерации. Фрагмент robots.txt с массивом исключений под фасетные URL.
Итерация 2: статичные URL и собственная таксономия
Вторая версия отказалась от параметров полностью. Статичный URL плюс блок перелинковки на всех листингах — вот и вся механика. Контент страницы при этом остался комбинацией внутреннего поиска и фасетов, но упакованной так, чтобы страница была самостоятельной единицей, а не представлением фильтра.
Таксономия папок
Контур разделён на четыре папки по типу среза. Разделение не косметическое: у каждой папки своя логика размножения по доменам и свой профиль индексации, и это разделение позволяет управлять ими независимо.
| Папка | Что закрывает | Особенность |
|---|---|---|
| Марки и модели | Марки, модели и подобное | Не зависит от языка — переводится даже на 80 доменов |
| Характеристики | Характеристики, например подборки по весу | Требует языковой адаптации формулировки |
| Локальные срезы | Локальные срезы | Привязка к географии, узкая языковая группа |
| Цены | Цены | Запущена последней, сентябрь 2026 |
Перелинковка: единственный вход
Другой навигации к тегам на сайте нет — весь вес и весь обход идут через один блок на листингах. Блок устроен просто: таблица с настоящими href-ссылками, ограничение 50 ссылок, выбор случайный.
Почему это важно. Случайный выбор из пула при большом количестве листингов даёт равномерное распределение внутренних ссылок по всему контуру без ручного управления. А настоящие href — условие, при котором ссылка вообще передаёт вес: блоки, где URL собирается на клиенте скриптом, для поисковика ссылками не являются.
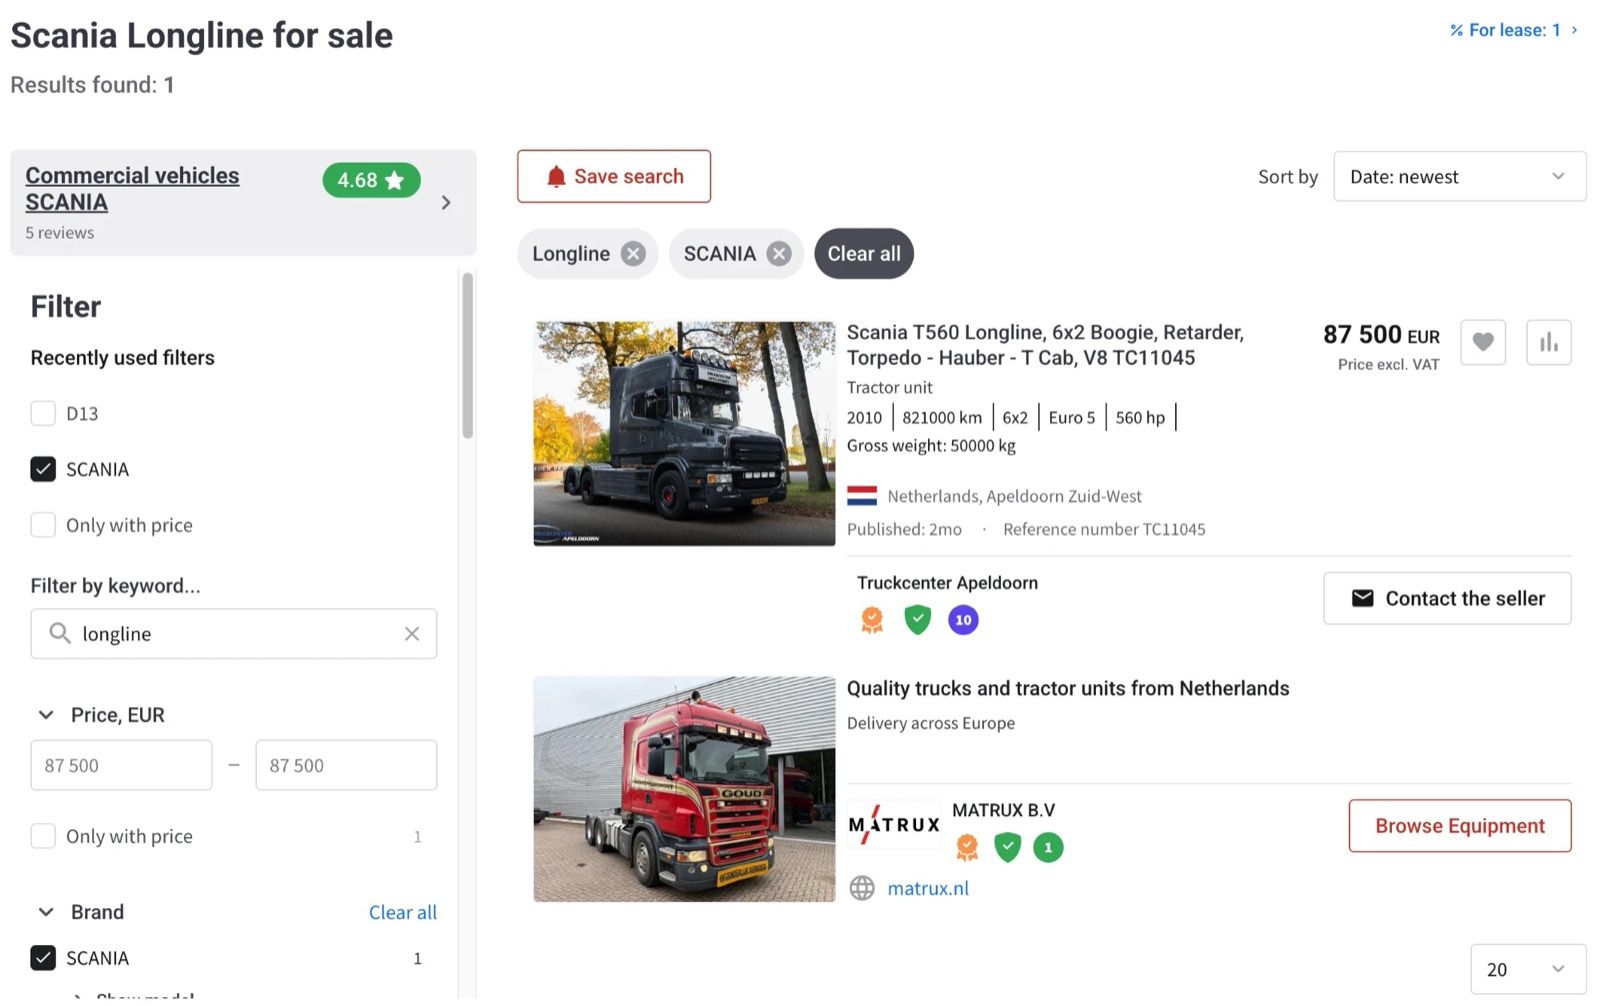
Теговая страница. Пример страницы контура: h1, мета, выдача объявлений.
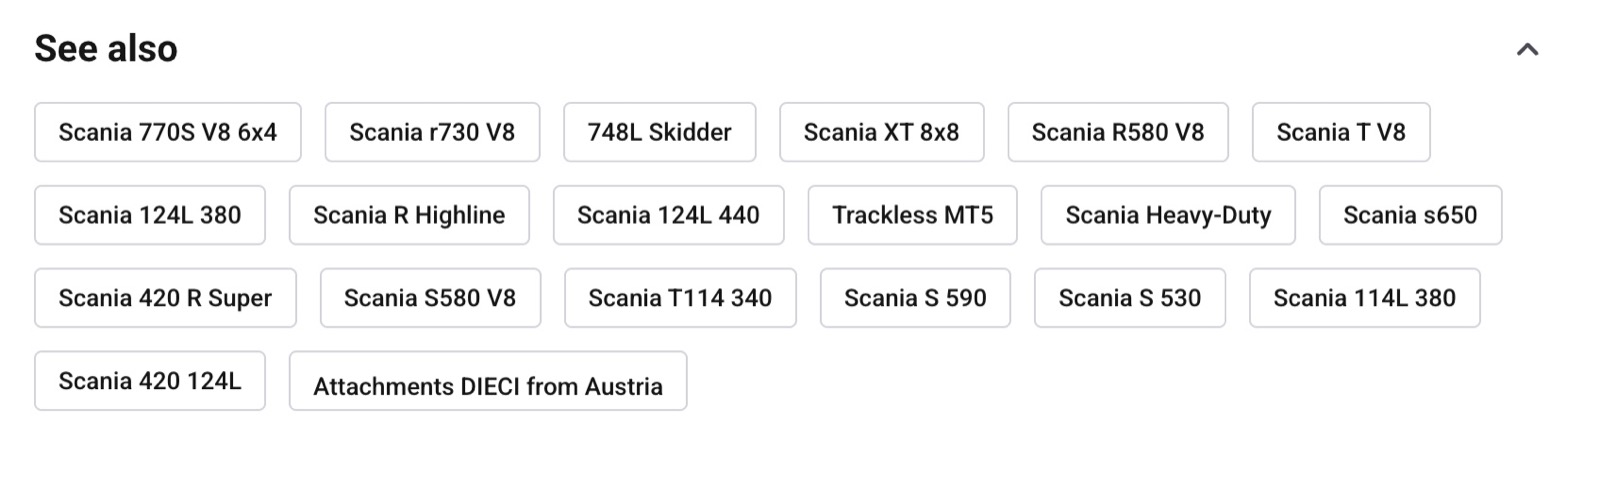
Блок перелинковки. «See also» на листинге + исходный код с href.
Языковая логика: принцип, который дал размножение
Теги имеют языковую привязку и публикуются только на домены своей языковой группы. Отсюда вопрос: как собирать семантику под 30+ языков, если по большинству из них данных в сервисах просто нет?
Рабочий принцип сформулировался так: формулировка тега различается от страны к стране — нужен самый частотный локальный вариант, — но информационная потребность за ней одна и та же и описывает один и тот же срез стока.
Следствие практическое и сильное: имея набор тегов на одном языке, можно найти самые частотные запросы на другом языке или составить их искусственно, если спрос не виден явно в сервисах по семантике. Это снимает зависимость от покрытия Ahrefs и Sistrix по малым рынкам — а именно там у сети доменов и находится незанятое поле.
Источники семантики — всё, откуда её удавалось достать: Ahrefs, Sistrix, Search Console, конкуренты, Keyword Explorer, собственный каталог, брейнштормы, разбор заголовков объявлений на n-граммы. Здесь было сделано очень много отдельных итераций, каждая со своей методикой.
Кросс-языковое размножение. Фрагмент словаря соответствий доменов и языков; адреса скрыты.
Процесс: правила, проверки, загрузка
Контур такого масштаба живёт или умирает на дисциплине подготовки. Ошибка в одном правиле умножается на количество доменов, поэтому набор правил фиксирован и проверяем.
Правила подготовки тегов
К семантике применяется весь стандартный арсенал подготовки: лемматизация и стемминг, нормализация написания марок, моделей и модификаций, удаление явных и неявных дублей, фильтрация по наличию стока, единые правила формирования URL и проверки на спецсимволы, кириллицу и некорректные коды ответа. Главный источник дублей в программатике — не логика, а разнобой в написании: одна и та же модификация может быть записана десятком способов, и без фиксированных правил именования контур начинает конкурировать сам с собой.
Процесс подготовки к загрузке
Процесс формализован в чеклист из полутора десятков шагов: от разделения датасета на языковые группы и проверки, что под тег соберётся выдача, до размножения по доменам, контроля чистоты размножения и передачи реестра в разработку. Единственный шаг, который не автоматизируется, — проверка правильности категории глазами. Конкретные шаги здесь не описываю: при интересе расскажу на звонке.
Проверка после публикации
Каждая партия после выкатки проверяется по одному чеклисту: страница онлайн и отдаёт 200; присутствует в sitemap; index, follow; прописаны мета-теги и h1; корректно выводится блок перелинковки.
Мониторинг: точность до URL
Решение, которое определило управляемость всего контура: все теги сразу складываются в сайтмапы по 1000 URL, на каждом домене отдельно.
Это не техническая формальность, а измерительный инструмент. Search Console отдаёт статистику по сайтмапу; при 1000 URL в файле и раздельных файлах по доменам индексация читается с точностью до конкретного URL — видно не только «сколько процентов зашло», но и какая именно партия, на каком домене и в какой папке не индексируется. Без этого контур в сотню с лишним тысяч страниц был бы чёрным ящиком.
Контур мониторится по четырём срезам: индексация (отдельное property в GSC плюс sitemap), трафик, количество ключевых слов и показов, процент soft 404.
Известные риски, которые отслеживаются
| Риск | Как проявляется |
|---|---|
| Дубли тегов | Разный URL, одинаковый набор объявлений |
| Пустые теговые страницы | Страница без предложений |
| Частичные дубли | Одно и то же предложение на нескольких страницах |
| Soft 404 | Страница отдаёт 200, но воспринимается как пустая |
| Конфликт директив | Страницы tag content имеют index, follow и одновременно добавлены исключениями в robots.txt — открытый баг |
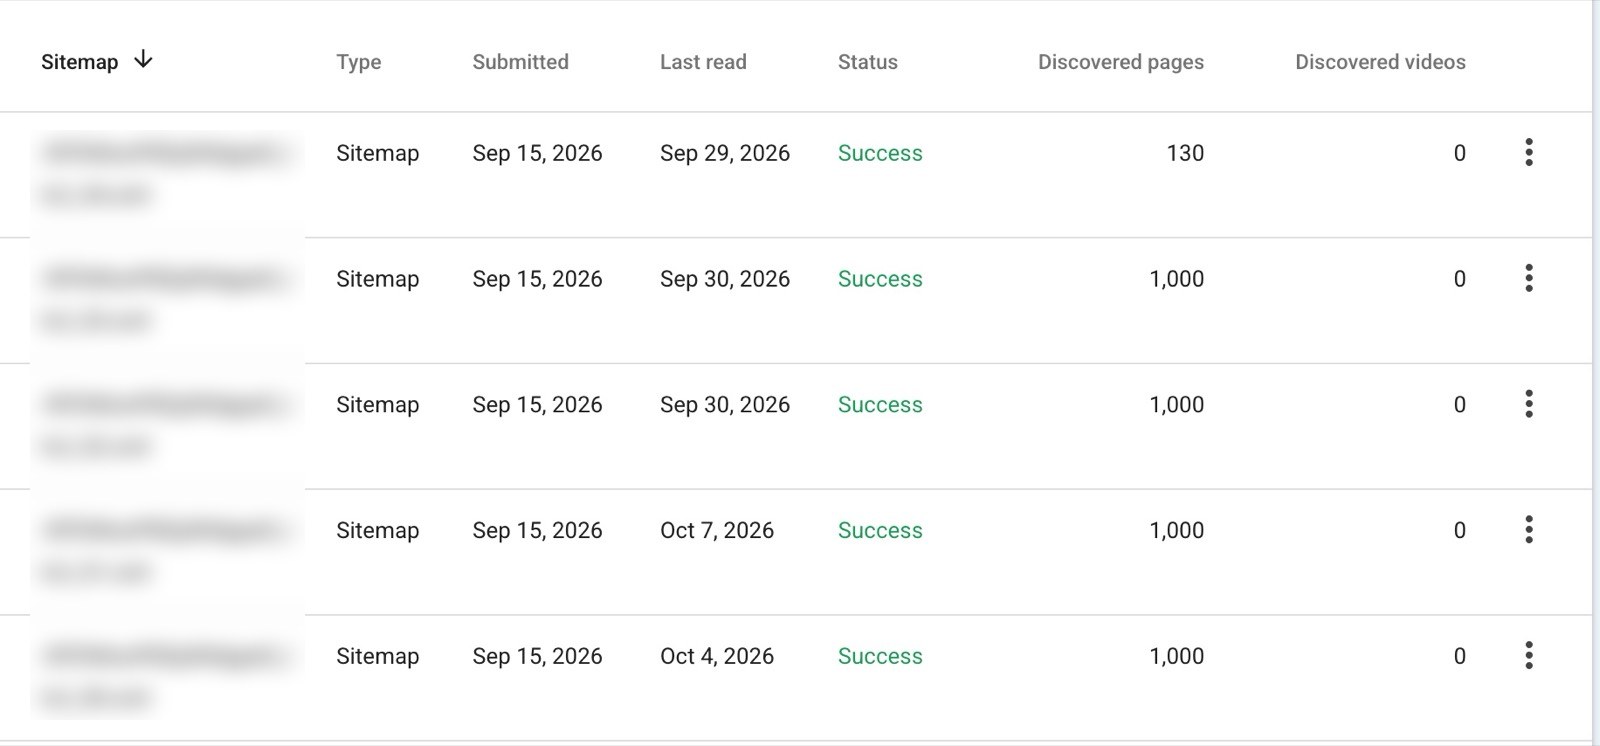
Сайтмапы по 1000 URL. Список сайтмапов в GSC с разбивкой по доменам и партиям.
Результат: масштаб
Индексация по папкам — снимок Search Console, конец июля 2026.
| Папка | Залито | В индексе | С показами |
|---|---|---|---|
| Марки и модели | десятки тысяч | 45% | 32% |
| Характеристики | десятки тысяч | 35% | 21% |
| Итого | больше ста тысяч | 41% | 28% |
Папка локальных срезов (около десяти тысяч страниц) из расчёта исключена: строка индексации по ней требует перепроверки — папка запустилась в апреле, июльская сборка могла её не подхватить. С её учётом общий объём контура — больше ста тысяч страниц на каждом домене.
Индексация по доменам — один и тот же механизм генерации, разброс более чем вдвое.
| Домен | В индексе |
|---|---|
| Основной домен сети | 55–65% |
| Испанский | 35–40% |
| Французский | 30–35% |
| Немецкий | 20–30% |
На каждом домене залито сопоставимое число страниц — десятки тысяч. Активных тегов — порядка двадцати тысяч: столько страниц получали показы за последний квартал. При этом спрос сезонный и географически неравномерный: часть тегов закрывает запросы, которые появляются только в свой сезон, а часть — срезы, востребованные лишь на отдельных рынках. Поэтому квартальный срез по четырём доменам занижает число работающих страниц, а годовой по всей сети был бы заметно выше.
Результат: трафик
Контур работает 13 месяцев. За это время он принёс сотни тысяч сессий.
| Период | Доля всего трафика контура | Что происходило |
|---|---|---|
| Сен 2025 | 3% | Запуск, марки и характеристики |
| Окт – дек 2025 | 17% | Раскат папки характеристик |
| Янв – мар 2026 | 23% | Характеристики выходят на объём |
| Апр – июн 2026 | 26% | Запуск локальных срезов |
| Июл – сен 2026 | 32% | Две партии автотегов, запуск цен |
В сутки: от сотен сессий на старте до тысяч в сентябре. Рост в 4,5 раза, плато не достигнуто. Сентябрьский run-rate — исторический максимум контура.
Вклад папок в сентябре: марки и модели — около двух третей, характеристики — около четверти, локальные срезы — около 6%, цены — около 3% в первый месяц работы.
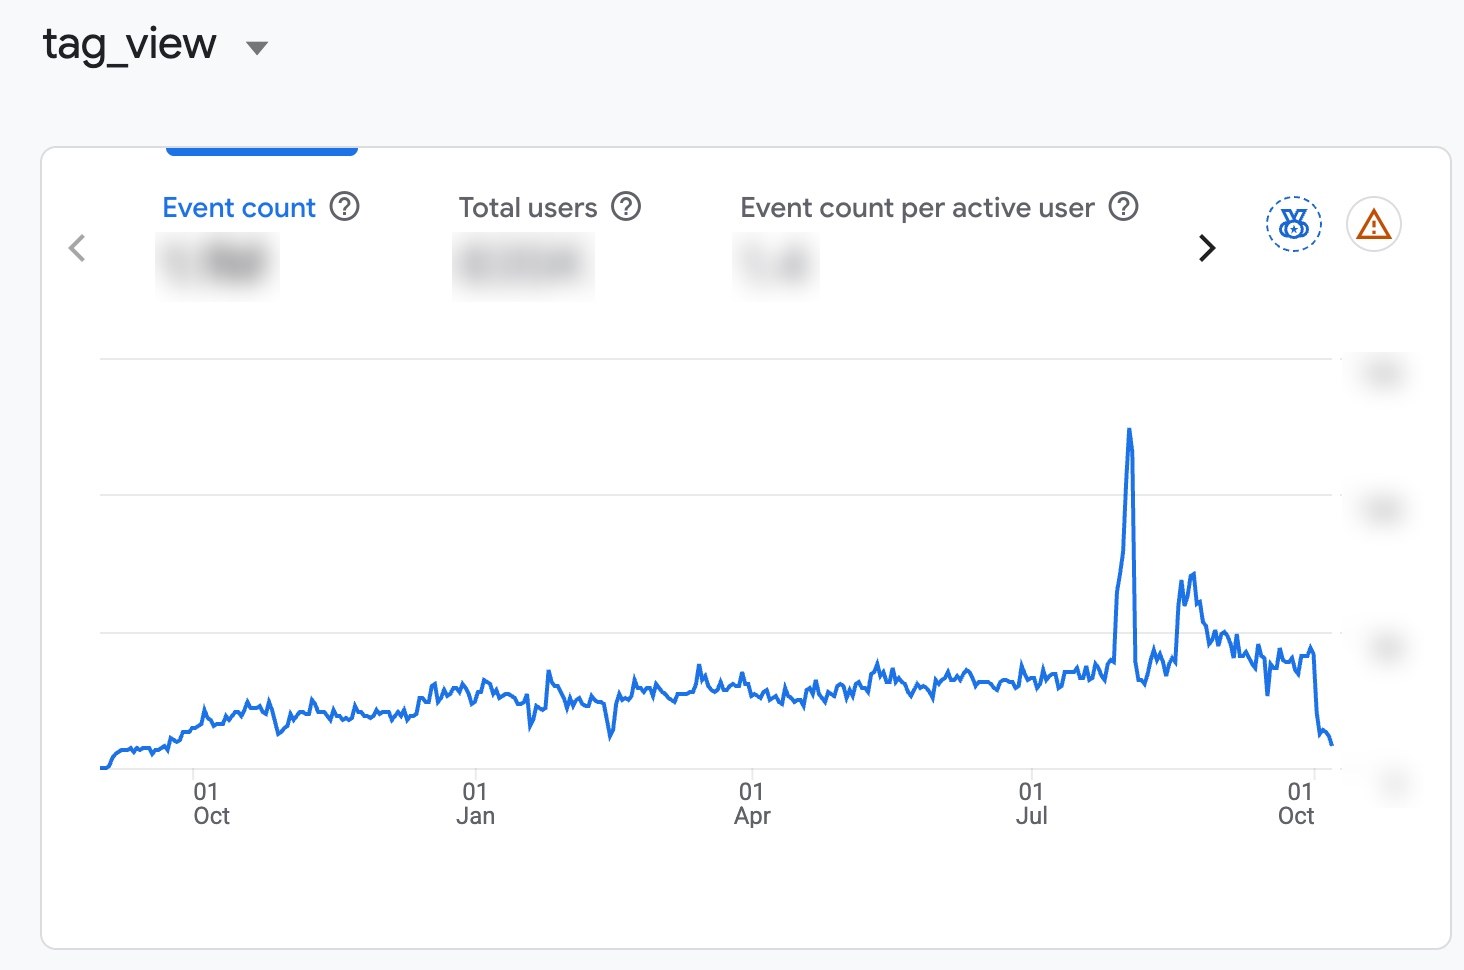
График трафика за 13 месяцев. Динамика просмотров теговых страниц; значения и шкала скрыты.
Результат: лиды и конверсия
За всё время работы контура — тысячи лидов и тысячи переходов на аукцион.
Веб-аналитика фиксирует меньше лидов, чем продуктовая: она считает только сессии со входом на теговую страницу. С поправкой на сессии, где тег просматривался внутри пути, оценки двух систем сходятся.
Текущий темп — сотни лидов в месяц при конверсии около 0,6%.
Конверсия стабильна девять месяцев подряд
| Период | CR |
|---|---|
| Сен – дек 2025 — разгон | 0,21% |
| Янв – сен 2026 — плато | 0,50% |
Контур выходил на свою конверсию четыре месяца. С января 2026 она держится в коридоре 0,44–0,59% без тренда — при том, что за этот срок трафик вырос вдвое, добавились две папки и две партии автотегов.
Что это значит. Рост контура — чисто объёмный. Новые страницы приводят спрос такого же качества, как зрелое ядро: масштабирование не разбавляет конверсию. Это существенно сильнее, чем просто «выросли в 4,5 раза».
Сентябрь идёт выше августа и по лидам в день, хотя август был рекордным месяцем.
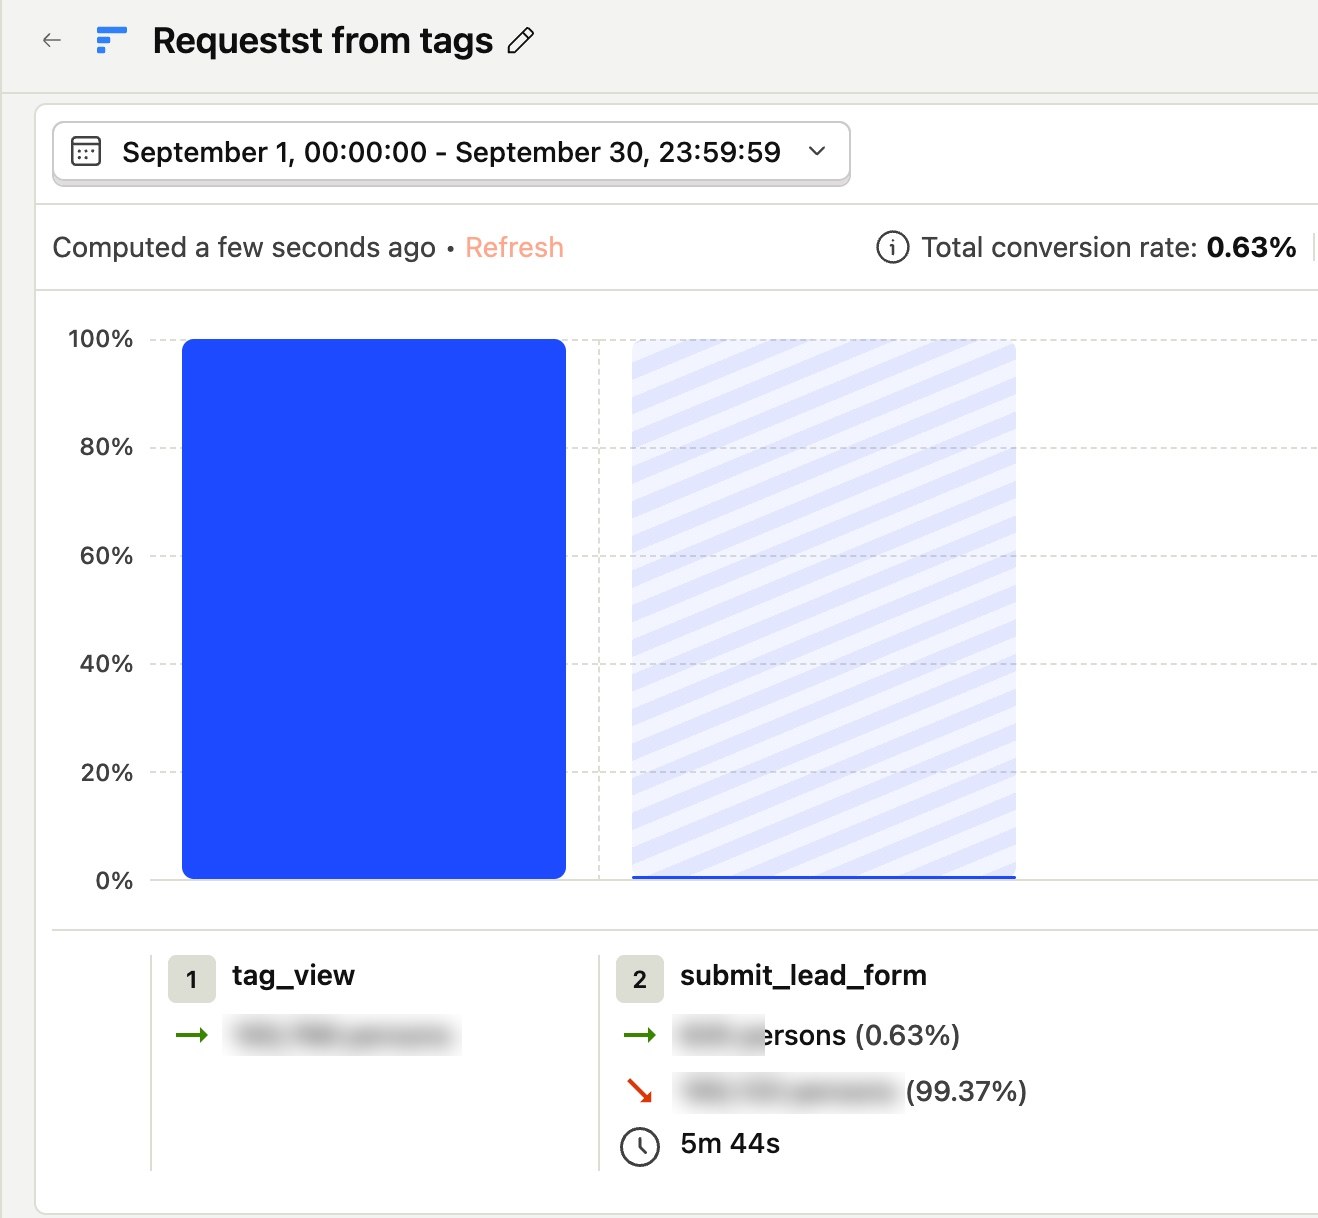
Воронка продуктовой аналитики. Просмотр тега → лид; доли оставлены, абсолютные значения скрыты.
Результат: вес в органике
Слой, которого год назад не существовало, даёт около 8% всей органики четырёх основных доменов. Окно — квартал, 22.06–21.09.2026.
| Домен | Доля тегов в органике | Средняя позиция тегов |
|---|---|---|
| Испанский | двузначная, больше 15% | около 15 |
| Французский | 7–8% | около 17 |
| Немецкий | 6–7% | около 13 |
| Основной | 5–6% | около 10 |
| Итого | около 8% |
В связке со вторым программатик-слоем. За то же окно и на тех же знаменателях страницы подборок по году добавляют ещё несколько процентов. Вместе два слоя, построенных в обход каталога, дают двузначную долю всей органики четырёх доменов.
Это уже не тактика, а архитектурный результат: заметная, двузначная доля органического трафика приходит со страниц, которых каталог в принципе не умеет создавать.
Потолок: индексация, а не генерация
Главный вывод по проекту сформулирован цифрами, а не ощущением.
- В индекс попадает около 40% залитого, показы получает 25%.
- Разброс между доменами — от 60% до 25% при одной и той же механике генерации. Значит, дело не в качестве страниц, а в том, как конкретный домен обходится и оценивается.
- На трёх доменах из четырёх уже лежат десятки тысяч залитых и непроиндексированных тегов.
Отдельное свойство механики: чем больше инвентарь, тем лучше результат. Контент теговой страницы — это предложения, которые в неё попадают. Чем больше сток, тем больше предложений на каждом теге, а значит, больше контента на странице, лучше поведенческие сигналы и выше её оценка поисковиком. Раздел растёт не только от новых страниц, но и от роста самого стока.
Практический вывод. Работа с индексацией уже залитого даст больше, чем любая новая партия. Рост стока сам по себе подтянет индексацию: практически все непроиндексированные страницы сидят в статусе Crawled — currently not indexed, то есть Google их обошёл и счёл слишком тонкими, а Discovered — currently not indexed почти нет: проблема обнаружения побеждена блоком перелинковки. Остаётся проблема содержания, а её решает инвентарь.
Тот же вывод независимо повторился на двух других программатик-проектах этой же сети: узкое место — охват, а не производство контента. Это системное свойство больших контуров, а не особенность одного проекта.
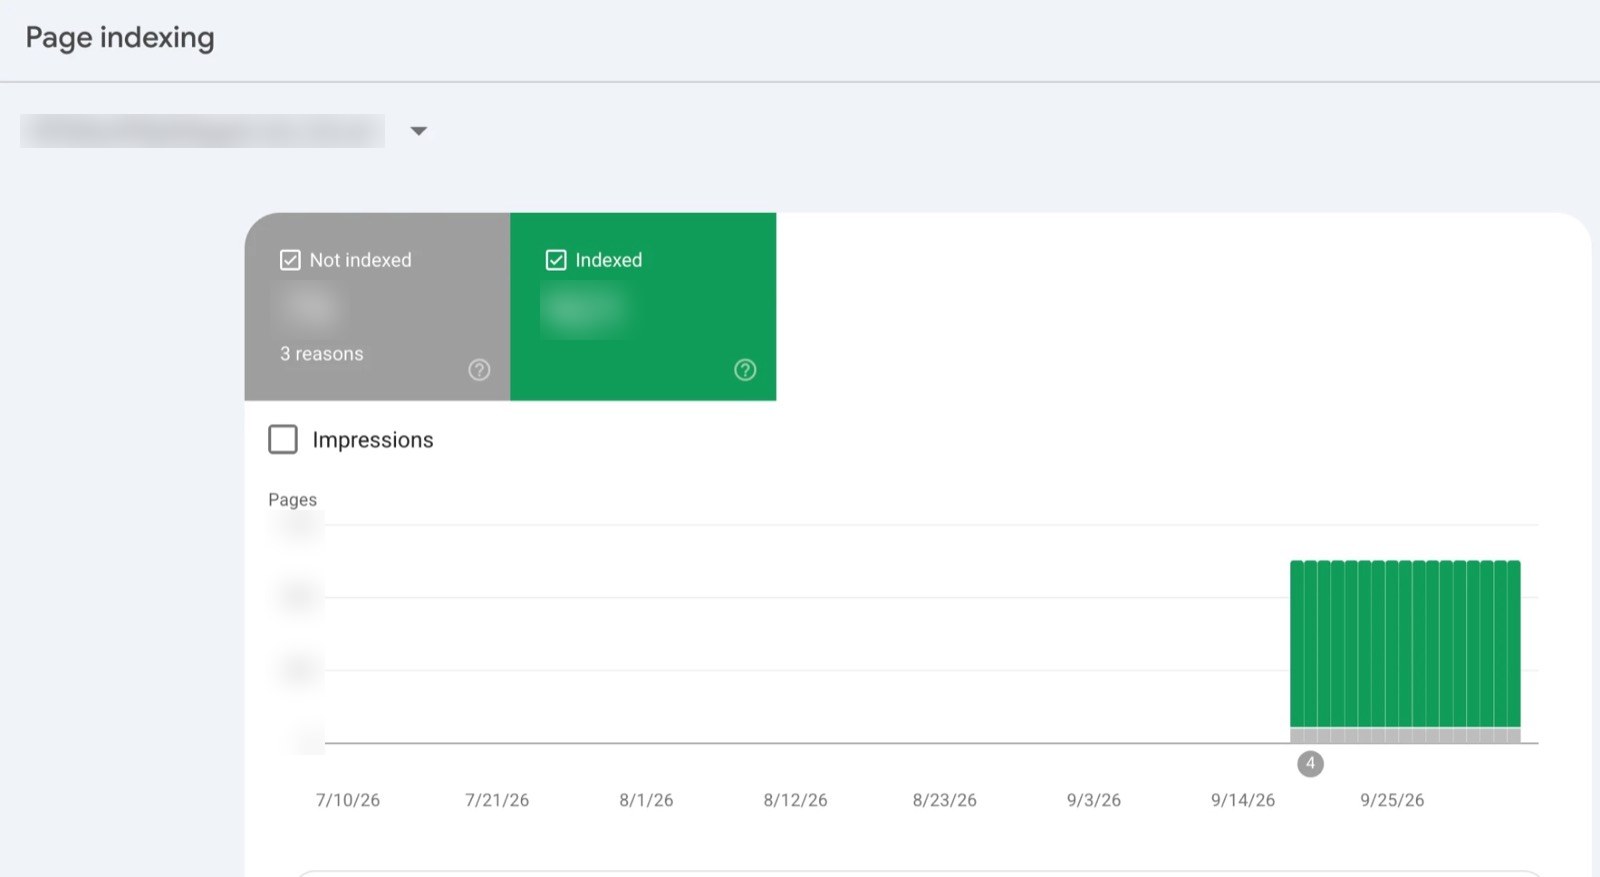
Индексация по сайтмапам. Отчёт GSC по одному сайтмапу: доля в индексе; значения скрыты.
Метод, который повторяется
- Найти границу системы, а не бороться с ней. Каталог нельзя было расширить — значит, нужен контур рядом с ним, со своими правилами и своим пространством URL.
- Статичный URL как условие существования страницы. Пока адрес выглядит как фасет, никакие директивы не делают страницу самостоятельной в глазах поисковика.
- Таксономия по типу среза, а не по удобству загрузки. Разделение на папки даёт независимое управление, независимое размножение по доменам и независимый замер.
- Один управляемый вход по ссылкам. Случайная выборка из пула на всех листингах + настоящие href = равномерное распределение веса без ручного управления. Эффект проверялся, а не предполагался: Link Score в Screaming Frog снимался до и после внедрения блока, и распределение внутреннего веса по теговым страницам после запуска выровнялось.
- Кросс-языковой перенос потребности. Формулировка локальна, потребность — нет. Это снимает зависимость от покрытия сервисов семантики на малых рынках.
- Измеримость закладывается в архитектуру. Сайтмапы по 1000 URL на домен — единственный способ получить индексацию с точностью до URL на контуре в сотни тысяч страниц.
- Фиксированные правила именования. Главный источник дублей в программатике — не логика, а разнобой в написании марок и модификаций.
Границы данных
- Индексация — снимок конца июля 2026. Search Console API не отдаёт список конкретных страниц по индексным корзинам: его можно выгрузить только из браузера, через интерфейс, по каждому из сотни с лишним сайтмапов. Руками это неподъёмно, поэтому выгрузка автоматизирована обходом интерфейса: сначала ZennoPoster, затем браузерное расширение Claude. За август–сентябрь залито ещё сотни тысяч страниц, знаменатель вырос — для сентябрьского среза выгрузку нужно повторять.